Sostituiamo Screaming Frog e risparmiamo 500 euro all’anno: Crawler SEO + Analisi AI
Mi sono ispirato a Screaming Frog per costruire un sistema con cui analizzare grandi quantità di pagine sul mio computer, con più libertà nel decidere cosa controllare. Così ho costruito con Codex un sistema di scansione e analisi SEO, accompagnato da una piccola interfaccia per consultare gli errori più rilevanti.
- Ambiente
- In locale, con possibilità di installazione su una VPS per scansioni periodiche e automatiche.
- Obiettivo
- Scansione, analisi e consultazione degli errori SEO
- AI nello sviluppo
- AstraArchitettura
- Luna · xhighRealizzazione del piano
- Sol 6.1Revisione del codice
Da dove sono partito
Uso Screaming Frog per le analisi SEO. I limiti della versione gratuita mi hanno spinto a costruire uno strumento locale, adattabile alle mie esigenze e senza una licenza aggiuntiva per il crawler.
Mi interessava poter scegliere quali URL analizzare e trasformare i risultati in dati da interrogare e confrontare. La piccola interfaccia serviva a rendere subito consultabili le criticità.
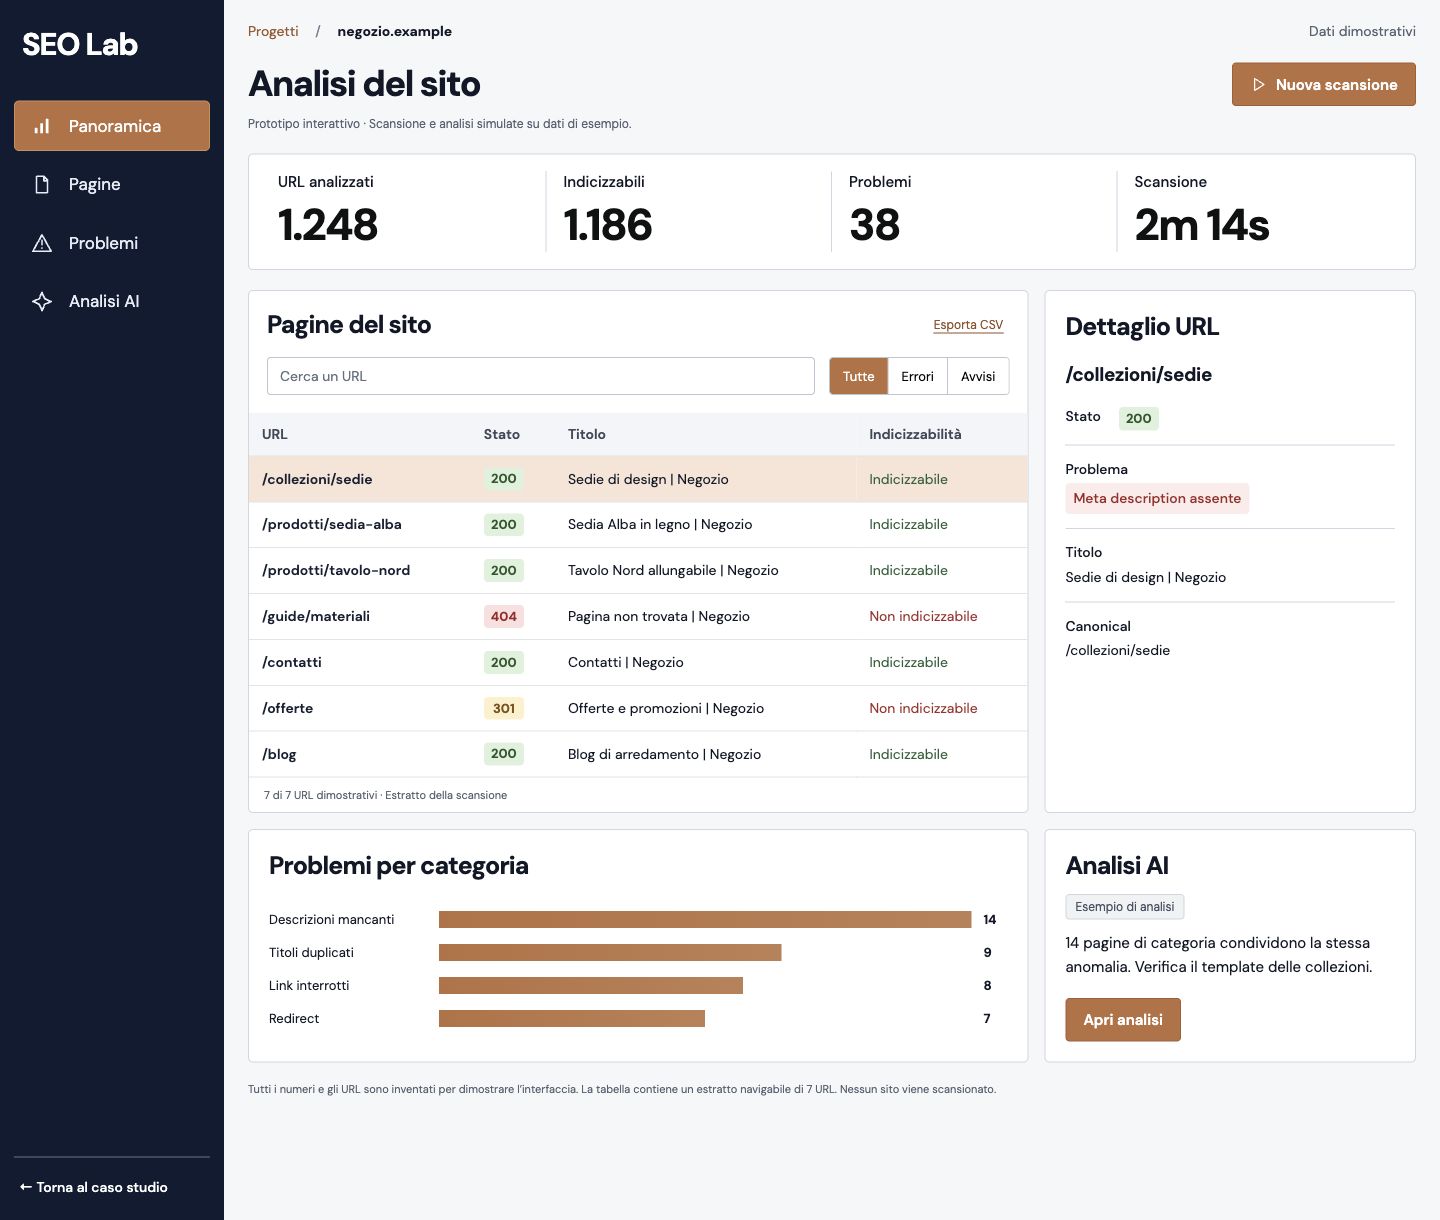
L’interfaccia
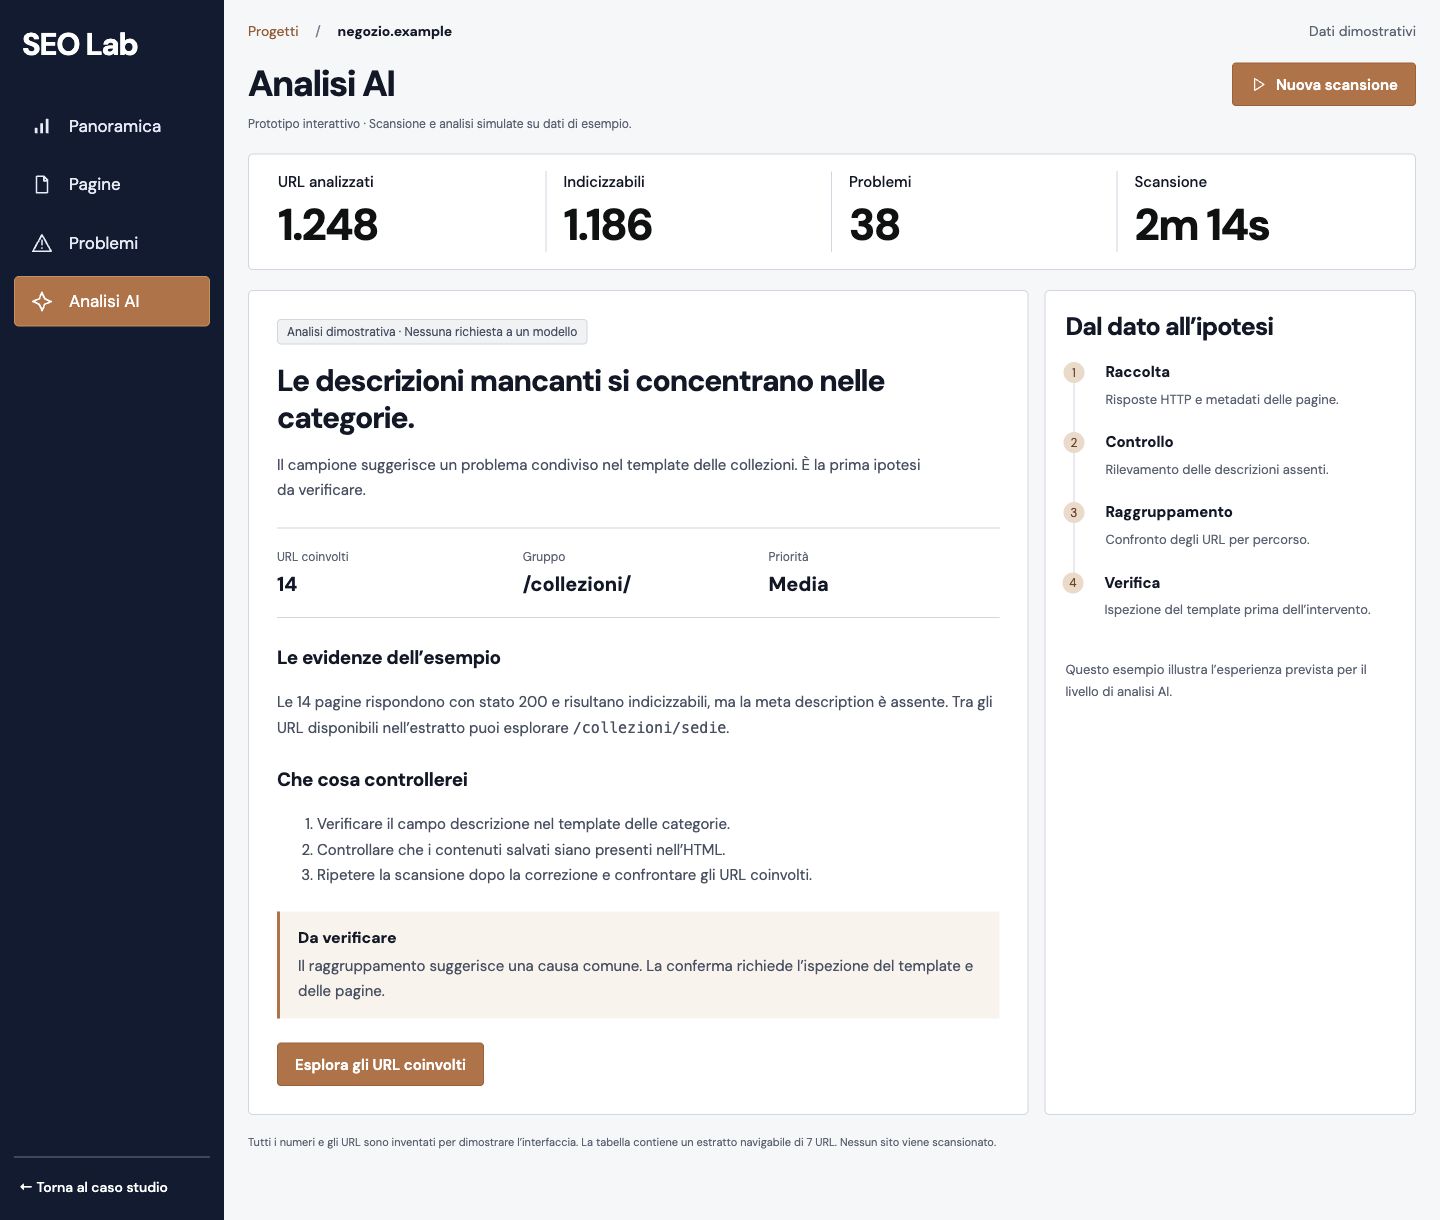
La panoramica permette di consultare gli URL e gli errori rilevati. Le schermate qui sotto illustrano l’interfaccia con dati dimostrativi.
Come è organizzato
L’architettura separa raccolta, controlli e interpretazione. Il crawler visita le pagine e recupera i dati.
- Scansione con PythonRichieste HTTP, scoperta degli URL e raccolta di pagine, collegamenti e metadati.
- Dati conservati e interrogabiliCon SQLite salvo pagine, URL e risultati in un database sul computer, senza dover gestire un server dedicato.Per confrontare le scansioni e cercare problemi ricorrenti uso DuckDB, che permette di filtrare e raggruppare i dati con query SQL direttamente in locale.Il formato Parquet conserva i dati in file compressi e organizzati per colonne. Questo mi consente di leggere soltanto le informazioni necessarie a ciascuna analisi.
- Controlli SEORegole distinte per risposte HTTP, titoli, descrizioni, canonical, indicizzabilità e collegamenti interni.
- Consultazione e approfondimentiUna piccola interfaccia per leggere gli errori. DeepSeek Flash 4.1 analizza i dati raccolti.
Questa struttura permette di aggiornare i controlli e rianalizzare i dati conservati, evitando una nuova scansione per ogni domanda.
Quali problemi può aiutarmi a individuare
Il perimetro dei controlli che ho definito per il tool comprende queste aree. La copertura di ogni scansione dipende dai moduli attivi, dalla configurazione e dai dati disponibili.
- Errori di risposta. Pagine non trovate, errori del server, richieste scadute e URL che non rispondono.
- Reindirizzamenti. Catene di redirect, cicli e collegamenti che passano inutilmente da più indirizzi.
- Titoli e descrizioni. Elementi mancanti, vuoti, duplicati o con lunghezze da rivedere.
- Intestazioni della pagina. H1 mancanti o multipli e gerarchie H1–H6 da controllare.
- Canonical e indicizzabilità. Canonical mancanti o incoerenti, destinazioni problematiche e conflitti tra direttive, blocchi e indicazioni di indicizzazione.
- Robots.txt e sitemap. URL bloccati, pagine presenti in sitemap con errori, redirect o direttive che ne impediscono l’indicizzazione.
- Collegamenti interni. Link interrotti, pagine troppo profonde, gruppi poco collegati e possibili pagine orfane, confrontando la scansione con sitemap o altri elenchi di URL.
- Contenuti. Duplicati esatti, pagine molto simili e contenuti con poco testo, da valutare nel loro contesto.
- Versioni linguistiche. Annotazioni hreflang incoerenti, destinazioni errate e collegamenti reciproci mancanti.
- Dati strutturati. Problemi di sintassi e struttura nei dati JSON-LD e Microdata, nei limiti delle regole di validazione configurate.
- Rendering JavaScript. Differenze tra HTML iniziale e pagina renderizzata, quando il modulo di rendering è attivo.
- Variazioni tra scansioni. Pagine aggiunte, rimosse o modificate e cambiamenti di stato, metadati, canonical e collegamenti.
L’analisi AI aiuta a collegare i segnali, cercare cause comuni e ordinare gli approfondimenti. Con le integrazioni previste, Search Console e PageSpeed possono aggiungere dati su visibilità organica e prestazioni. Le segnalazioni richiedono una verifica sulle pagine coinvolte.
Come ho lavorato con l’AI
Per l’analisi SEO dei dati raccolti ho usato DeepSeek Flash 4.1.
Ho usato Astra per definire l’architettura, Luna con ragionamento xhigh per realizzare il piano e Sol 6.1 per la revisione del codice. Il lavoro è passato da moduli con compiti precisi, così da poter controllare separatamente raccolta dei dati, analisi e presentazione dei risultati.
La distinzione tra un errore tecnico rilevato dal programma e una sua possibile spiegazione guida il progetto. Un collegamento interrotto è un dato da verificare. Capire perché centinaia di collegamenti risultano interrotti richiede un approfondimento.
Gli sviluppi previsti
L’evoluzione prevista è un agente capace di scegliere autonomamente quali dati interrogare, ampliando l’analisi AI già eseguita sui dati raccolti. Python esegue le richieste consentite e restituisce i risultati al modello, che può approfondire l’analisi fino a formulare una diagnosi accompagnata dalle evidenze.
Nel piano rientrano confronti tra scansioni, collegamenti a Search Console e PageSpeed e, con accesso autorizzato al codice del sito, proposte di correzione da revisionare. Ogni estensione richiede una propria implementazione e verifica.
Limiti
L’esecuzione locale dipende dalle risorse del computer. Tempo di scansione e memoria diventano vincoli da misurare quando crescono gli URL. L’assenza di una licenza aggiuntiva per il crawler lascia comunque da considerare sviluppo, manutenzione ed eventuali costi delle API AI.
Le scansioni vanno configurate con un ambito e limiti di richieste adeguati. L’analisi AI dipende dalla qualità dei dati raccolti e le ipotesi vanno verificate sulle pagine coinvolte.
Quindi...
Per questo progetto ho ottenuto un risparmio di 500 euro all’anno, evitando l’acquisto della licenza di Screaming Frog. Il crawler copre le analisi per cui l’ho costruito e aggiunge l’analisi AI dei dati raccolti. Il risparmio indicato riguarda la licenza evitata. Sviluppo, manutenzione ed eventuali API restano costi da considerare.
Il tool ha ancora molti limiti. Il Vibe Coding mi permette di affrontarli rapidamente, estendendo l’agente con nuovi controlli, strumenti e integrazioni man mano che emergono esigenze concrete. Posso così sviluppare e verificare nuove funzioni in tempi brevi.